Правило первой трети: где ИИ на самом деле читает вашу страницу
Обновлено:
Быстрый ответ: 44,2% всех цитирований ИИ берутся из первой трети текста страницы. Не из лучшего абзаца, не из заключения, которое вы шлифовали час. Сверху. Если внутри этой первой трети нет самодостаточного ответа на 40 до 80 слов, модели нечего забрать, и она уходит на страницу, где он есть.
Одна эта цифра изменила то, как мы оцениваем содержание в собственном движке, и объясняет картину, которая ставит владельцев сайтов в тупик: по-настоящему хорошая статья, которую никто не цитирует.
Почему верх страницы весит больше остального?
Системы поиска не читают вашу страницу. Они её режут.
Прежде чем языковая модель сможет использовать написанное вами, страница проходит нарезку: текст делится на фрагменты, каждый превращается в вектор, и поиск идёт по фрагментам. Модель никогда не видит вашу статью как статью. Она видит груду кусков и выбирает те, что похожи на ответ.
Отсюда три следствия, которые большинство советов по контенту до сих пор игнорирует.
Стена текста это сломанный фрагмент. Когда абзац разрастается, разрез приходится на середину мысли. Наружу выходит половина рассуждения без подлежащего. Поиск либо перескажет его своими словами, и тогда пропадут ваши формулировки и ваша ссылка, либо отбросит.
Самодостаточность важнее красоты. Абзац, понятный сам по себе, забирают целиком. Абзац, который держится на трёх предыдущих, не забирают, потому что те три лежат в других фрагментах.
Положение работает как признак уверенности. Системы, вынужденные выбирать между фрагментами, склоняются к ранним, потому что там документы обычно говорят, о чём они. Цифра 44,2% это видимый результат такого смещения.
- Чанк
- Кусок текста, которым оперирует система извлечения: обычно один абзац или несколько подряд.
- Первая треть
- Верхняя часть страницы, из которой берутся 44,2% всех цитирований ИИ.
Посмотрите, как обстоят дела у вашей страницы
172 проверки в 8 группах, десять секунд, без регистрации.
Проверить страницуЧто «первая треть» значит на практике?
Правило не про первые 30% ваших слов в отвлечённом смысле. Оно про то, что находит машина, когда начинает читать.
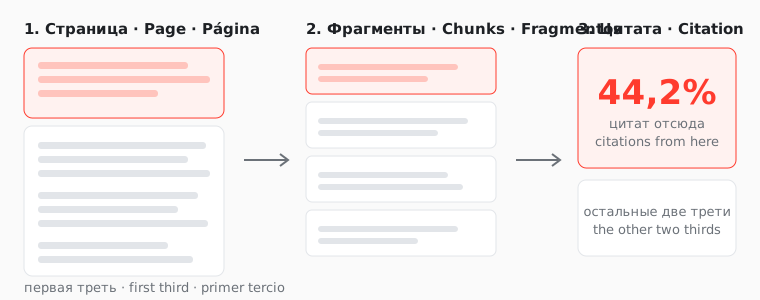
Конкретно: прямой ответ на 40 до 80 слов, помещённый либо в первой трети текста без разметки, либо в первом абзаце под вашим <h1> или первым <h2>. В журналистике это называют «главное вперёд». Это противоположность структуре, которой пользуется почти весь коммерческий контент, где ответ приходит после трёх абзацев подводки.
Проверка простая. Возьмите страницу, удалите всё кроме первой трети и дайте человеку, который ваш сайт не видел. Сможет он сказать, на что страница отвечает? Если нет, модель тоже не сможет.
Чаще всего вижу одно: мысль размазана по странице. Ответ есть, но собирается из четырёх абзацев сверху донизу. Человек дочитает и соберёт. Модель берёт первую треть и уходит.
Какая длина абзаца переживает нарезку?
Наравне с положением судьбу фрагмента решает длина.
Абзацы примерно на 40 до 120 слов переживают нарезку целыми. Ниже сорока абзац редко несёт законченную мысль, поэтому его сливают с соседями и он теряет границы. Выше ста двадцати разрез начинает приходиться на середину рассуждения.
Это самый невзрачный совет в работе с содержанием и один из самых надёжных. Вы пишете не под метрику читаемости. Вы пишете единицы, которым придётся стоять самостоятельно после того, как машина их вырежет.
Наш движок мерит это долей: какая часть ваших абзацев попадает в рабочую полосу. Страница, где большинство абзацев по два-три предложения, набирает хорошо. Страница из длинных изящных блоков набирает плохо, какой бы хорошей ни была проза.
Чего это не чинит?
Здесь большинство статей по теме обещает лишнего, поэтому скажу прямо.
Правильно выстроенная первая треть не приносит цитирований. Она делает вас цитируемым. Это разные состояния, и в промежутке между ними живёт большинство сайтов.
Мы это измерили на себе. Пять страниц seo7.es, скан движком v1.2 от 27 августа 2026:
| Страница | Цитируемость | Техника | Содержание |
|---|---|---|---|
| Главная | 63 | 82% | 63% |
| Услуги | 59 | 84% | 55% |
| Цены | 66 | 85% | 66% |
| Блог | 57 | 85% | 53% |
| Контакты | 59 | 85% | 55% |
Техническая колонка почти ровная, от 82 до 85%. Содержательная гуляет от 53 до 66 и объясняет почти весь разброс. Проверка «ответ вверху» провалена на главной и возглавляет список правок движка с четырьмя баллами.
Четыре. Не сорок.
В тот же день мы спросили четыре языковые модели, назовут ли они наш домен, когда клиент просит агентство нашего профиля. Двадцать четыре ответа. Ноль упоминаний.
Наши страницы выстроены достаточно хорошо, чтобы их извлекали. Модели не знают, что мы существуем. Это две разные задачи, и решение первой не трогает вторую.
Почему совет всё равно верен?
Если одна структура цитирований не приносит, зачем возиться?
Потому что это половина, которую вы контролируете полностью.
Память о бренде, то есть знает ли модель ваше имя вообще, движется медленно. Она берётся из упоминаний на чужих сайтах, из отзывов, из того, что вас обсуждают. Повлиять можно, но не на этой неделе.
Извлекаемость движется за вечер. Перепишите начало так, чтобы оно отвечало в пятьдесят слов. Разбейте стены текста на единицы. Поставьте выжимку наверх, а не вниз. Это правки, а не кампании.
И порядок важен. Модель, решившая вас процитировать и не нашедшая в первой трети ничего пригодного, процитирует другого. Готовность по структуре это то, что заставит узнаваемость окупиться, когда она наконец появится.
Какие три проверки можно сделать сегодня?
Есть ли в первой трети самодостаточный ответ? Сорок до восьмидесяти слов, без местоимений, указывающих на прежние абзацы, без «как мы говорили выше». Если человек, попавший на этот абзац без разбега, получает полный ответ, вы прошли.
Переживают ли ваши абзацы вырезание? Возьмите три случайных из середины страницы. Прочитайте каждый отдельно. Если два бессмысленны без соседей, нарезка работает против вас.
Ваша выжимка вверху или внизу? Многие сайты ставят краткие выводы в конец, как резюме. Для поиска это худшее положение: она оказывается в последнем фрагменте, после всего, что могло бы сделать её находимой.
Как выглядит фрагмент на самом деле?
Проще увидеть на паре реальных абзацев.
Написано для человека:
Мы работаем в этой сфере уже не первый год, и за это время видели, как заметно менялся ландшафт. То, что работало раньше, больше не работает, и причины стоит разобрать, потому что они уходят в самую суть того, как развивались эти системы и что они теперь поощряют.
Вырежьте это из контекста, и оно не говорит ничего. Ни подлежащего, ни утверждения, ни цифры. Система, забравшая такой фрагмент, забрала воздух.
Написано с расчётом на нарезку:
Системы ИИ берут 44,2% своих цитат из первой трети страницы. Причина механическая: поиск делит страницы на фрагменты до ранжирования, а ранние фрагменты обычно говорят, о чём документ.
Тот же регистр, тот же тон, но этот стоит сам. В нём цифра, утверждение и механизм за ним. Поднятый в ответ, он остаётся осмысленным и по-прежнему требует атрибуции, из которой и берётся ваша ссылка.
Разница не в мастерстве письма. Первый вариант, пожалуй, лучше как проза. Разница в том, можно ли отделить абзац от страницы и оставить его работающим.
Часто задаваемые вопросы
Работает ли это для длинных материалов? Тем более. В руководстве на три тысячи слов больше фрагментов, а значит больше шансов, что какой-то извлекут, и больше шансов, что сломанный отбросят. Правило первой трети держится независимо от длины, потому что оно про то, куда поиск смотрит первым делом, а не про то, сколько вы написали.
А если страница отвечает на несколько вопросов? Тогда у неё несколько первых третей в миниатюре. Каждый <h2> должен открываться собственным самодостаточным ответом. Поиск работает с фрагментами, а раздел ближе к фрагменту, чем целая страница.
Нужно ли удалять вступление? Нет. Передвиньте ответ вперёд. Контекст по-прежнему важен для того, кто остался. Просто он не должен стоять между читателем и сутью.
Не вредят ли короткие абзацы человеку? Два-три предложения это длина, которую и так рекомендует большинство руководств по стилю для веба. Редкий случай, когда оптимизация под машины и под людей указывает в одну сторону.
Достаточно ли блока с выжимкой? Он помогает, и наш движок считает его отдельно, но он не замена. Выжимка говорит модели, что страница утверждает. Самодостаточный ответ внутри текста даёт модели то, что можно процитировать.
Как понять, что сработало? В позициях вы этого не увидите, потому что это не фактор ранжирования. Видно, если спрашивать модели напрямую, называют ли они вас, и следить, появляются ли ваши формулировки в ответах. Ровно для этого мы и собрали жюри из четырёх моделей.
Что мы изменили в собственной оценке?
Цифра 44,2% одна из немногих в этой области, что взята из измерения, а не из чьего-то поста, и поэтому весит в нашей модели по-настоящему: 90 баллов из 3405, среди самых тяжёлых содержательных сигналов.
Но мы также научились отделять то, что она предсказывает, от того, чего не предсказывает. В нынешнем движке структура страницы и память о бренде это два независимых числа, а не один смешанный балл. Страница может быть идеально извлекаемой и всё равно невидимой, а одно число прячет ровно этот случай.
Если забирать отсюда одну мысль: первая треть вашей страницы это не вступление. Это часть, которую читают машины, а всё, что ниже, читают люди, уже решившие остаться.
Источники: компендиум исследований по 165 источникам о поиске с ИИ (август 2026); измерения GEO-bench; сканы seo7.es движком GeoScan v1.2 от 27 августа 2026.